大數據架構與模式(五) 基于解決方案模式與產品選型的數據處理與存儲支持服務
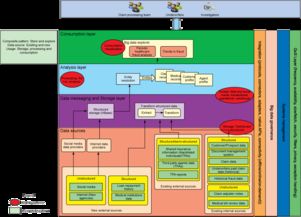
在構建大數據系統(tǒng)時,將通用解決方案模式與具體的產品技術相結合,是確保系統(tǒng)高效、可靠且可擴展的關鍵。本部分聚焦于如何針對特定的大數據問題應用已驗證的解決方案模式,并在此基礎上選擇合適的技術產品,以構建強大的數據處理與存儲支持服務體系。
一、 核心大數據解決方案模式的應用
面對海量、多源、高速的數據,典型的解決方案模式為技術選型提供了藍圖。
- 數據采集與注入模式:針對不同數據源(日志、傳感器、數據庫變更、消息隊列等),采用相應的模式。例如,對于實時流數據,應用“發(fā)布-訂閱”或“事件流處理”模式;對于批量歷史數據,則采用“批量提取與加載”模式。模式的選擇直接決定了后續(xù)對采集工具(如Flume, Kafka, Sqoop, Debezium)的需求。
- 數據存儲與組織模式:根據數據的結構、訪問模式和一致性要求,混合使用多種存儲模式。這包括:
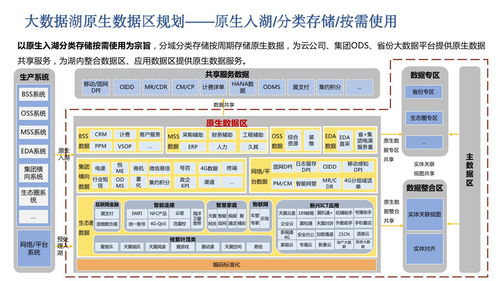
- 原始數據湖模式:用于存儲未經處理的原始數據,支持任意格式,為探索性分析保留靈活性。
- 分層存儲與“Lambda/Kappa架構”模式:結合批處理和流處理路徑,構建熱、溫、冷數據分層,平衡成本與性能。
- 多模型存儲模式:根據具體場景,組合使用鍵值存儲、文檔數據庫、列式存儲、圖數據庫等,而非依賴單一存儲解決所有問題。
- 數據處理與分析模式:
- 批處理模式:適用于對數據完整性、準確性要求高,但時效性要求相對寬松的場景,如日終報表、歷史數據挖掘。
- 流處理模式:適用于需要實時響應的場景,如欺詐檢測、實時監(jiān)控。微批處理和連續(xù)處理是其主要實現(xiàn)方式。
- 交互式查詢模式:服務于數據探索和即席查詢,要求低延遲的SQL或類SQL接口。
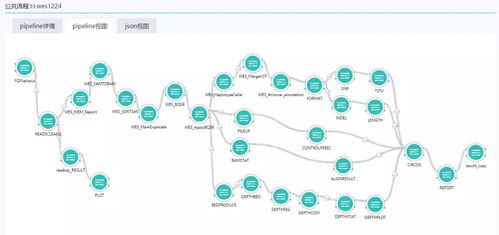
- 機器學習管道模式:標準化數據清洗、特征工程、模型訓練與評估、模型部署的流程。
二、 基于模式的產品選型策略
在明確解決方案模式后,產品選型需綜合考慮多個維度,避免技術堆砌。
- 匹配模式與產品能力:將模式需求映射到產品特性。例如:
- 流處理模式 → 評估Apache Flink(狀態(tài)化精確一次處理)、Apache Spark Streaming(微批處理)、Apache Kafka Streams(輕量級庫)在吞吐量、延遲、狀態(tài)管理、容錯方面的差異。
- 交互式查詢模式 → 對比Apache Hive on Tez/LLAP、Presto/Trino、ClickHouse、Impala等在ANSI SQL支持、多數據源聯(lián)邦查詢、并發(fā)能力和響應速度上的表現(xiàn)。
- 生態(tài)系統(tǒng)與集成度:優(yōu)先選擇與現(xiàn)有或計劃中的技術棧集成良好的產品。例如,在Hadoop生態(tài)內,Spark、Hive、HDFS的集成更為順暢;在云原生環(huán)境下,Kubernetes與Flink、Presto的云托管服務(如AWS EMR, Azure HDInsight, GCP Dataproc)可能是更優(yōu)選擇。
- 可擴展性與運維成本:評估產品的水平擴展能力、監(jiān)控管理工具的成熟度以及社區(qū)/商業(yè)支持的力度。開源產品活躍的社區(qū)是重要資產,而商業(yè)發(fā)行版或云托管服務則能降低運維復雜性。
- 總擁有成本(TCO):除了軟件許可費用(如有),更需計算硬件資源消耗、人力運維成本以及云環(huán)境下的具體計費模型(存儲、計算、數據傳輸)。
三、 構建數據處理與存儲支持服務
最終目標是將選定的產品組合,以服務的形式提供穩(wěn)定、高效的數據支撐能力。
- 統(tǒng)一的數據接入服務:基于采集模式,構建標準化的API、SDK或配置化工具,屏蔽底層Kafka、Flume等產品的復雜性,為業(yè)務方提供簡便的數據注入通道。
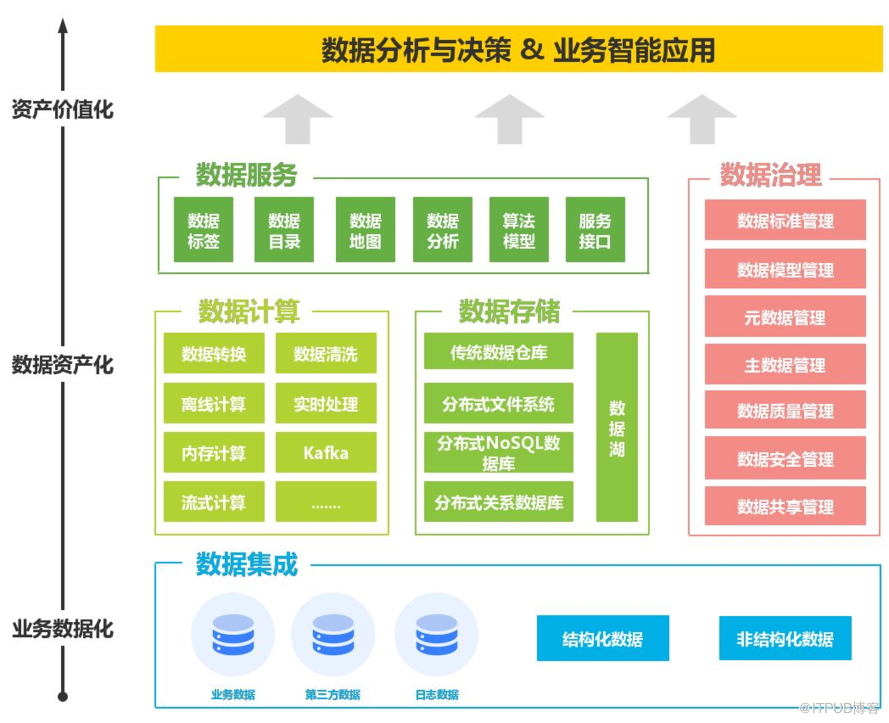
- 彈性的數據存儲服務:整合對象存儲(如AWS S3)、分布式文件系統(tǒng)(HDFS)、各類NoSQL數據庫及數據倉庫,通過統(tǒng)一的元數據管理層(如Apache Hive Metastore, AWS Glue Data Catalog)提供一致的數據目錄和訪問視圖。實施智能的生命周期管理策略,自動將數據在不同存儲層間遷移。
- 多樣化的數據處理服務:提供菜單式的處理能力:
- 批量計算服務:基于Spark或MapReduce引擎,提供任務調度(Airflow, DolphinScheduler)、資源隊列管理。
- 流計算服務:提供Flink或Spark Streaming作業(yè)的托管平臺,支持作業(yè)提交、狀態(tài)監(jiān)控、彈性擴縮容。
- 即席查詢服務:部署Presto/Trino集群,并提供查詢網關、多租戶資源隔離和查詢歷史分析。
- 數據治理與質量服務:這是支持服務的“軟實力”核心。集成數據血緣追蹤、數據質量校驗規(guī)則引擎、敏感數據脫敏與安全策略,確保在高效處理的保障數據的可靠性、安全性與合規(guī)性。
- 平臺化與自助服務:通過平臺門戶將上述服務能力產品化。數據開發(fā)者可以自助申請資源、提交作業(yè)、管理管道;數據分析師可以自助探索數據、運行查詢、獲取數據集。
###
成功的大數據架構并非最新技術的簡單羅列,而是針對業(yè)務問題,精準應用解決方案模式,并理性選擇與之匹配的技術產品的結果。最終形成的數據處理與存儲支持服務,應是一個平臺化、自動化、智能化的支撐體系,它能夠靈活適配多變的業(yè)務需求,同時確保數據資產被安全、高效、可持續(xù)地管理和利用,從而為數據驅動決策奠定堅實的技術基礎。從模式到產品,再到服務,是實現(xiàn)大數據價值最大化的系統(tǒng)化路徑。
如若轉載,請注明出處:http://m.gogirl.cn/product/51.html
更新時間:2026-10-13 08:43:09